ShowUI: One Vision-Language-Action Model for GUI Visual Agent
閱讀經典VLA model
ShowUI: One Vision-Language-Action Model for GUI Visual Agent
Read with ChatGPT 5.6 Sol medium
核心資訊
- 標題: ShowUI: One Vision-Language-Action Model for GUI Visual Agent
- 標題翻譯: ShowUI:面向 GUI 視覺代理的單一視覺—語言—動作模型
- 作者: Kevin Qinghong Lin、Linjie Li、Difei Gao、Zhengyuan Yang、Shiwei Wu、Zechen Bai、Weixian Lei、Lijuan Wang、Mike Zheng Shou
- 機構: Show Lab, National University of Singapore;Microsoft
- 發表時間: 2024-11-26
- 發表管道: arXiv 預印本
- arXiv: 2411.17465
- 論文連結: https://arxiv.org/abs/2411.17465
- 程式碼 / 專案: https://github.com/showlab/ShowUI
- 資料 / 資源: 256K GUI 指令微調樣本,涵蓋網頁、行動裝置與桌面環境
- 論文類型: 方法/系統論文
原文摘要翻譯
近來,大型視覺—語言模型已被用來建立圖形使用者介面助理,展現出極具潛力的功能。然而,多數語言代理仍仰賴封閉式模型應用程式介面,以及 HTML 原始碼或無障礙樹等文字化介面,因而缺乏有效的視覺感知能力。本文提出 ShowUI,一個可直接在畫面像素上進行圖形介面操作的視覺—語言—動作模型。其創新包含三部分:第一,將畫面建模成使用者介面連通圖,並依畫面冗餘程度進行自注意力視覺權杖選擇;第二,提出交錯式視覺—語言—動作串流,在導航時保留視覺與動作歷史,或在訓練時讓同一張畫面對應多組查詢與動作,以提升效率;第三,透過資料篩選與重新取樣建立小而高品質的圖形介面指令資料集。以僅 2B 參數與 256K 筆資料,ShowUI 在零樣本畫面定位上達到 75.1%,同時減少 33% 的冗餘視覺權杖並獲得 1.4× 的速度提升。作者亦在網頁、行動裝置與線上環境中檢驗其導航能力,並公開模型與程式碼。
創新點
- 以介面結構驅動視覺權杖稀疏化。
UI-Guided Visual Token Selection不先訓練額外router,而是把相鄰且顏色相近的畫面區塊組成連通元件,再從重複區域中抽樣權杖;目標是省下注意力計算,同時保留原始位置編碼與可點擊位置。 - 把圖形介面代理統一成視覺—文字—動作串流。
Action-Visual Streaming將前一步畫面與動作納入後續預測,Action-Query Streaming則讓多個指令共用同一張畫面的視覺權杖,分別處理長程狀態與訓練攤銷效率。 - 資料價值不只來自規模,而來自視覺必要性與分布平衡。 作者移除僅靠文字即可定位的網頁元素,為桌面畫面擴增外觀、空間與情境式查詢,並平衡不同資料來源;消融顯示這些處理比直接堆入更多元素更有效。
- 以小模型檢驗一條更偏工程效率的路線。 論文使用
Qwen2-VL-2B與256K訓練樣本,而非依賴更大的模型或結構化介面輸入,藉此測試純視覺代理能否同時兼顧定位能力、導航能力與運算成本。
一句話總結
ShowUI 真正的貢獻,是把「高解析度畫面中的重複視覺權杖、跨步驟狀態,以及品質不一的 GUI 監督」整理成一套可訓練的小型純視覺代理配方;但標題中的「單一模型」不等於已證明它能在開放世界中穩定完成長程、可復原且安全的自動化任務。
研究問題
具體痛點
純視覺圖形介面代理面臨三個彼此牽連的瓶頸。第一,高解析度畫面會產生大量視覺權杖,但背景、留白與大面積同色區域高度重複;若全部送入自注意力,成本隨序列長度快速增加。第二,介面操作本質上是多步決策,下一個動作取決於先前看過的畫面與已執行的動作,單張截圖問答難以表達狀態轉移。第三,現成資料常含大量可由文字辨識直接解決的元素,或被少數裝置與任務分布主導,未必真的訓練到視覺定位與操作能力。
與既有路線的差異
比起HTML 或 Android 類型可直接拆出元素結構的情境比起,更多情況會是只有畫面可用的。為能順利使用這一通用方法,需自行解決定位與歷史狀態問題,showUI考慮的是在不依賴結構化介面資訊的前提下,能否用有限模型與資料預算,學出跨網頁、桌面與行動裝置的畫面定位及動作生成能力?
資料與任務定義
資料來源與監督
訓練集合共約 256K 筆樣本、2.7M 個元素或動作標註,分成靜態定位與導航兩類。網頁定位資料包含作者自行蒐集的 22K 張截圖:由原始 926K 個元素移除靜態文字等較不需要視覺判斷的項目後,保留約 576K 個元素。AMEX 提供約 97K 張截圖、885K 個元素及 178K 個功能描述。桌面端使用 OmniAct 的 100 張截圖與約 2K 筆原始標註,再以外觀、空間關係與使用情境生成多樣化查詢,擴增至約 6K 筆元素級監督。
導航資料則來自網頁版 GUIAct 的 72K 筆軌跡與行動版 GUIAct 的 65K 筆軌跡,平均動作鏈長度分別約為 7.9 與 9.0。訓練時,網頁定位、行動定位、桌面定位、網頁導航與行動導航以 1:1:1:1:1 取樣,避免樣本量較大的來源壓過其他環境。
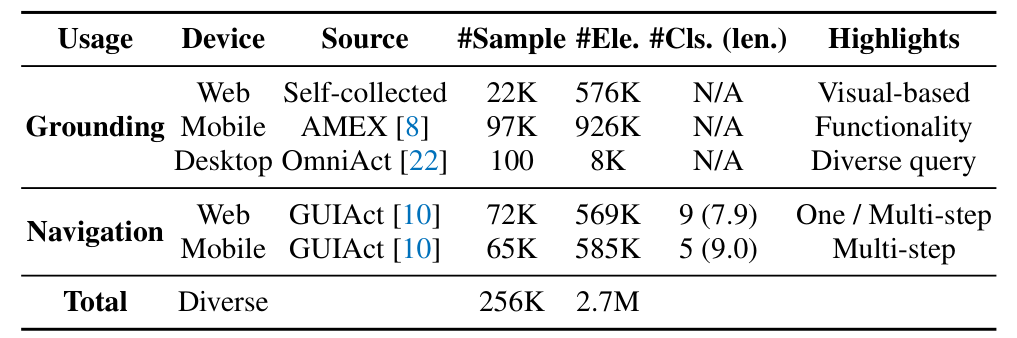 論文原圖編號:Table 1。指令微調資料的來源、樣本數、元素數與動作鏈長度;置於此處可快速核對
256K 資料配方的實際構成。
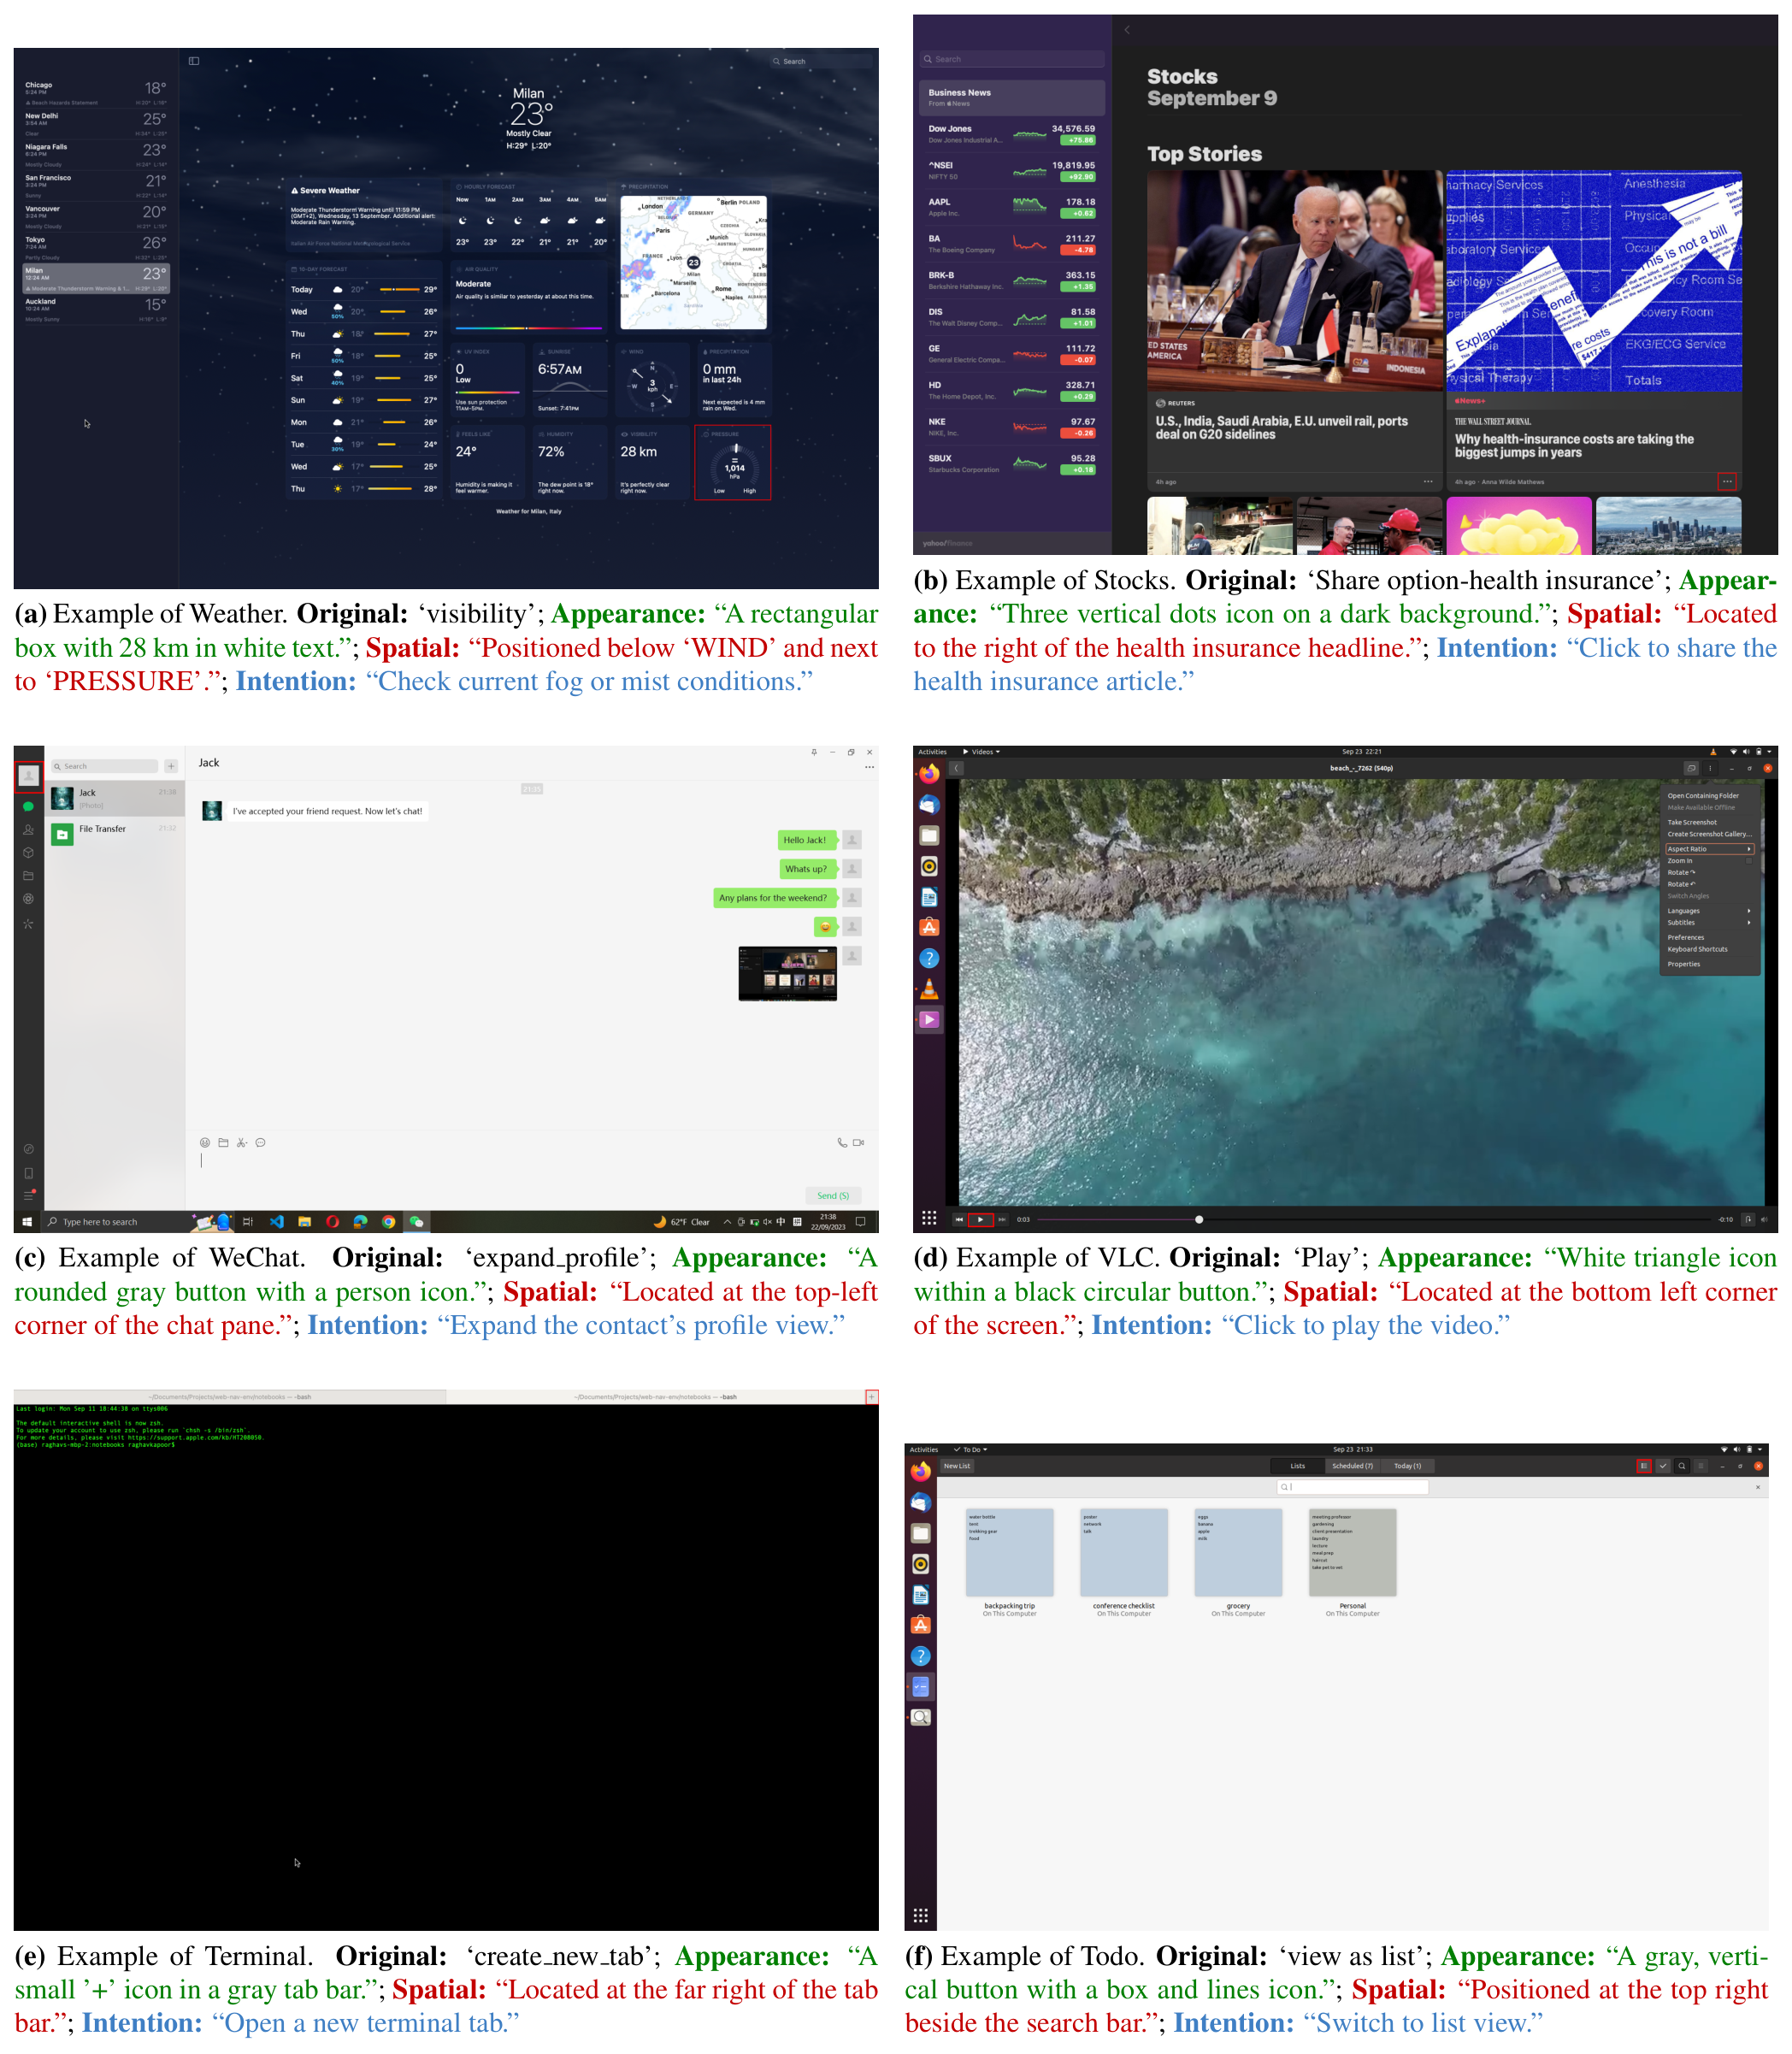 論文原圖編號:Figure 8。桌面資料由單一座標標註擴增為外觀、空間關係與情境式查詢;這說明資料增強如何要求模型理解畫面,而不只是記住元素文字。
任務輸入與輸出
模型的輸入是自然語言任務、目前或歷史截圖,以及預先定義的動作空間;輸出統一成包含動作名稱、可選文字值與正規化座標的結構,例如 {action, value, position:[x,y]},其中座標縮放至 。靜態定位只需從一張畫面預測目標點;導航則要逐步預測點擊、輸入、滑動等動作,並接收動作後的新畫面。
論文沒有直接預測 DOM 節點、無障礙樹節點或可執行程式碼,也沒有把靜態定位分數等同於完整任務成功率。這個區分很重要:定位回答的是「應操作哪裡」,導航還包含動作類型、參數、歷史依賴與錯誤累積。
[!figure] Algorithm 1 使用者介面連通元件搜尋 建議位置:資料與任務定義 放置原因:原演算法以相鄰色差與 Union-Find 定義畫面區塊,是理解視覺權杖選擇單位的形式化依據。 目前狀態:保留占位;未找到可獨立使用且高置信度的完整演算法圖塊,正文已依原文重建其步驟。
方法主線
機制流程
- 輸入與視覺編碼: 將任務文字、動作空間與目前截圖送入以
Qwen2-VL-2B為基礎的模型;畫面經切塊與合併後形成帶有原始位置編碼的視覺權杖。 - 使用者介面圖與權杖選擇: 以水平、垂直相鄰區塊的平均色差建立邊,利用
Union-Find求出連通元件;訓練時在大型元件內隨機略過部分權杖,單例區塊保留,輸出較短但位置仍對齊原畫面的視覺序列。 - 交錯式序列建模: 依任務格式,把多步的畫面—動作歷史串成
Action-Visual Streaming,或讓同一畫面後接多組查詢—動作監督形成Action-Query Streaming;語言模型損失只施加在應預測的動作位置。 - 動作生成與環境回饋: 模型自回歸產生結構化動作與座標,環境執行後回傳新畫面;新觀察與有限歷史再進入下一輪,直到完成任務或達到停止條件。
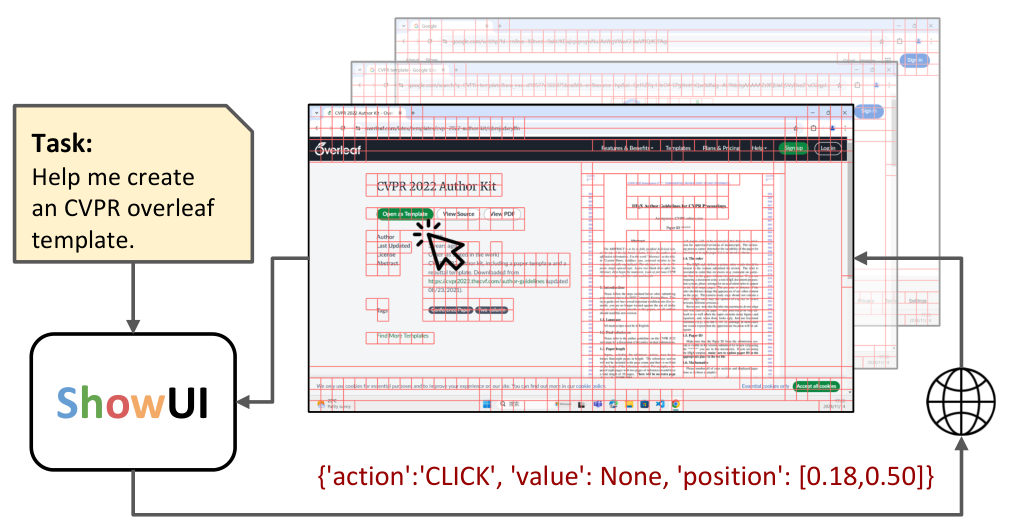 論文原圖編號:Figure 1。
ShowUI 從文字任務與畫面產生介面動作的概念總覽;置於流程開頭可建立輸入、模型與環境回饋的整體關係。
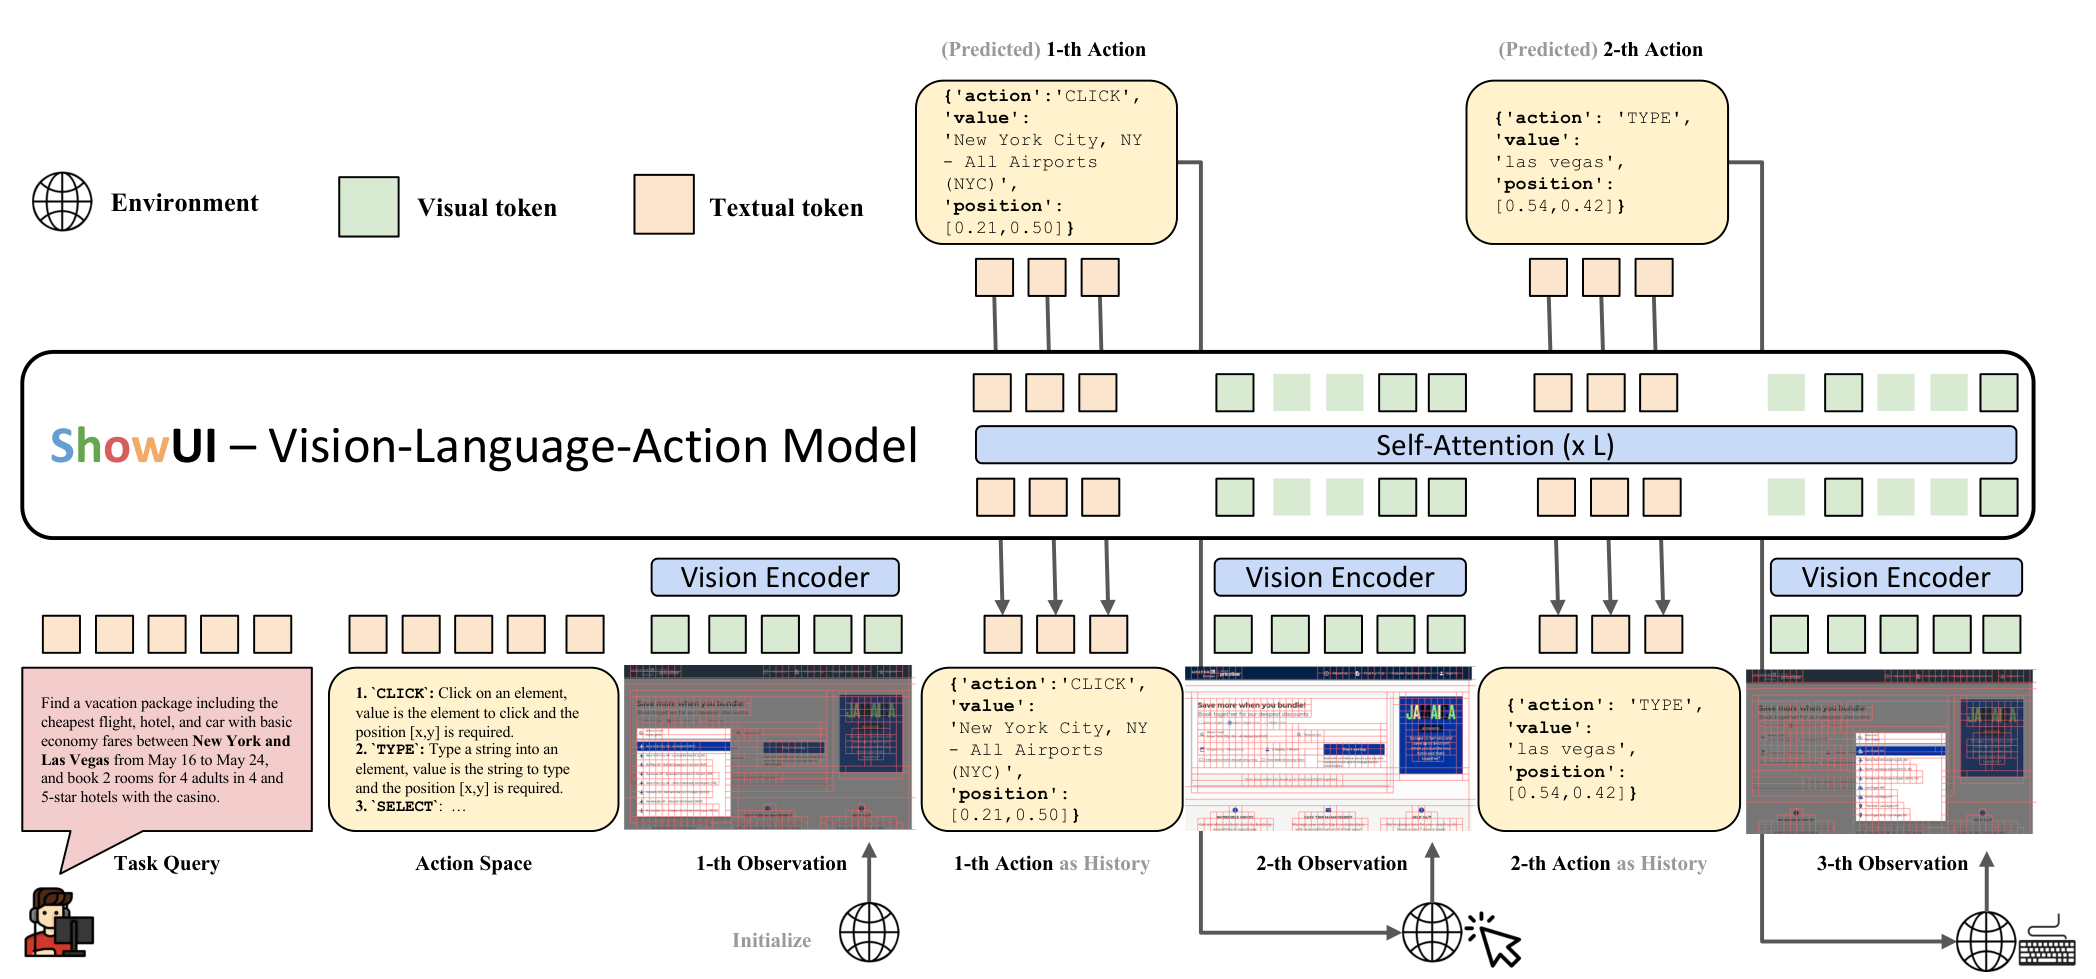 論文原圖編號:Figure 3。完整展示視覺、文字、動作權杖在多步導航中的排列與回饋;它是理解實際執行鏈最關鍵的系統圖。
使用者介面圖與視覺權杖選擇
若原始畫面高、寬為 ,每個視覺區塊的有效邊長為 ,則圖的網格大小為
工程上,這只是把視覺編碼器產生的區塊排列還原成二維網格。對每個節點,只檢查右方與下方鄰居;若兩者的平均 RGB 向量滿足
就合併兩個集合。Union-Find 最後得到 個連通元件,作為「可能重複的介面區域」。訓練時在每個非單例元件中隨機選取保留權杖,推論時則可均勻抽樣;方法不新增可學習參數,也不改寫被保留權杖的原始位置編碼。
這裡刻意採用「選擇」而非「合併」。若把一大片背景或控制元件壓成單一向量,雖然更省序列長度,卻可能抹除精確座標與局部差異;選擇仍會丟失資訊,但留下的權杖可維持與畫面座標的一對一對應。作者把稀疏模組交錯插入模型層,最佳消融設定是在中間層附近交叉使用,而非所有層一律稀疏化。
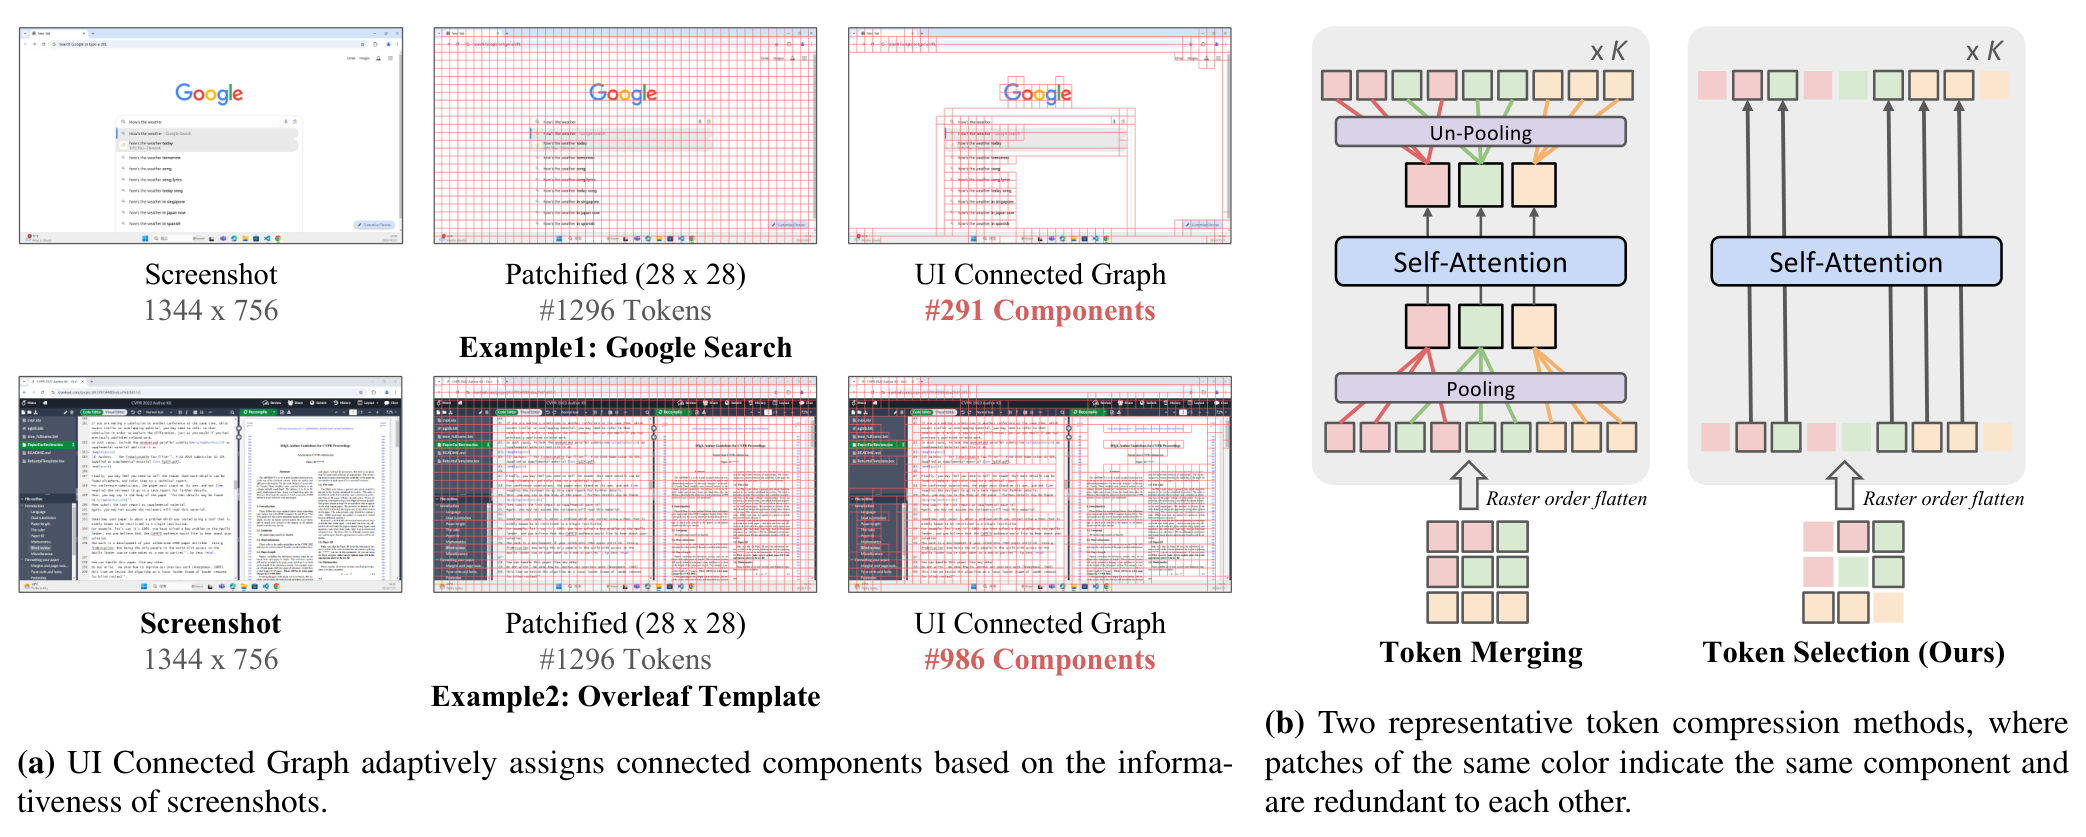 論文原圖編號:Figure 4。從畫面網格、連通元件到權杖合併與選擇的直接對照;它呈現「省計算但保留位置」這項設計抉擇。
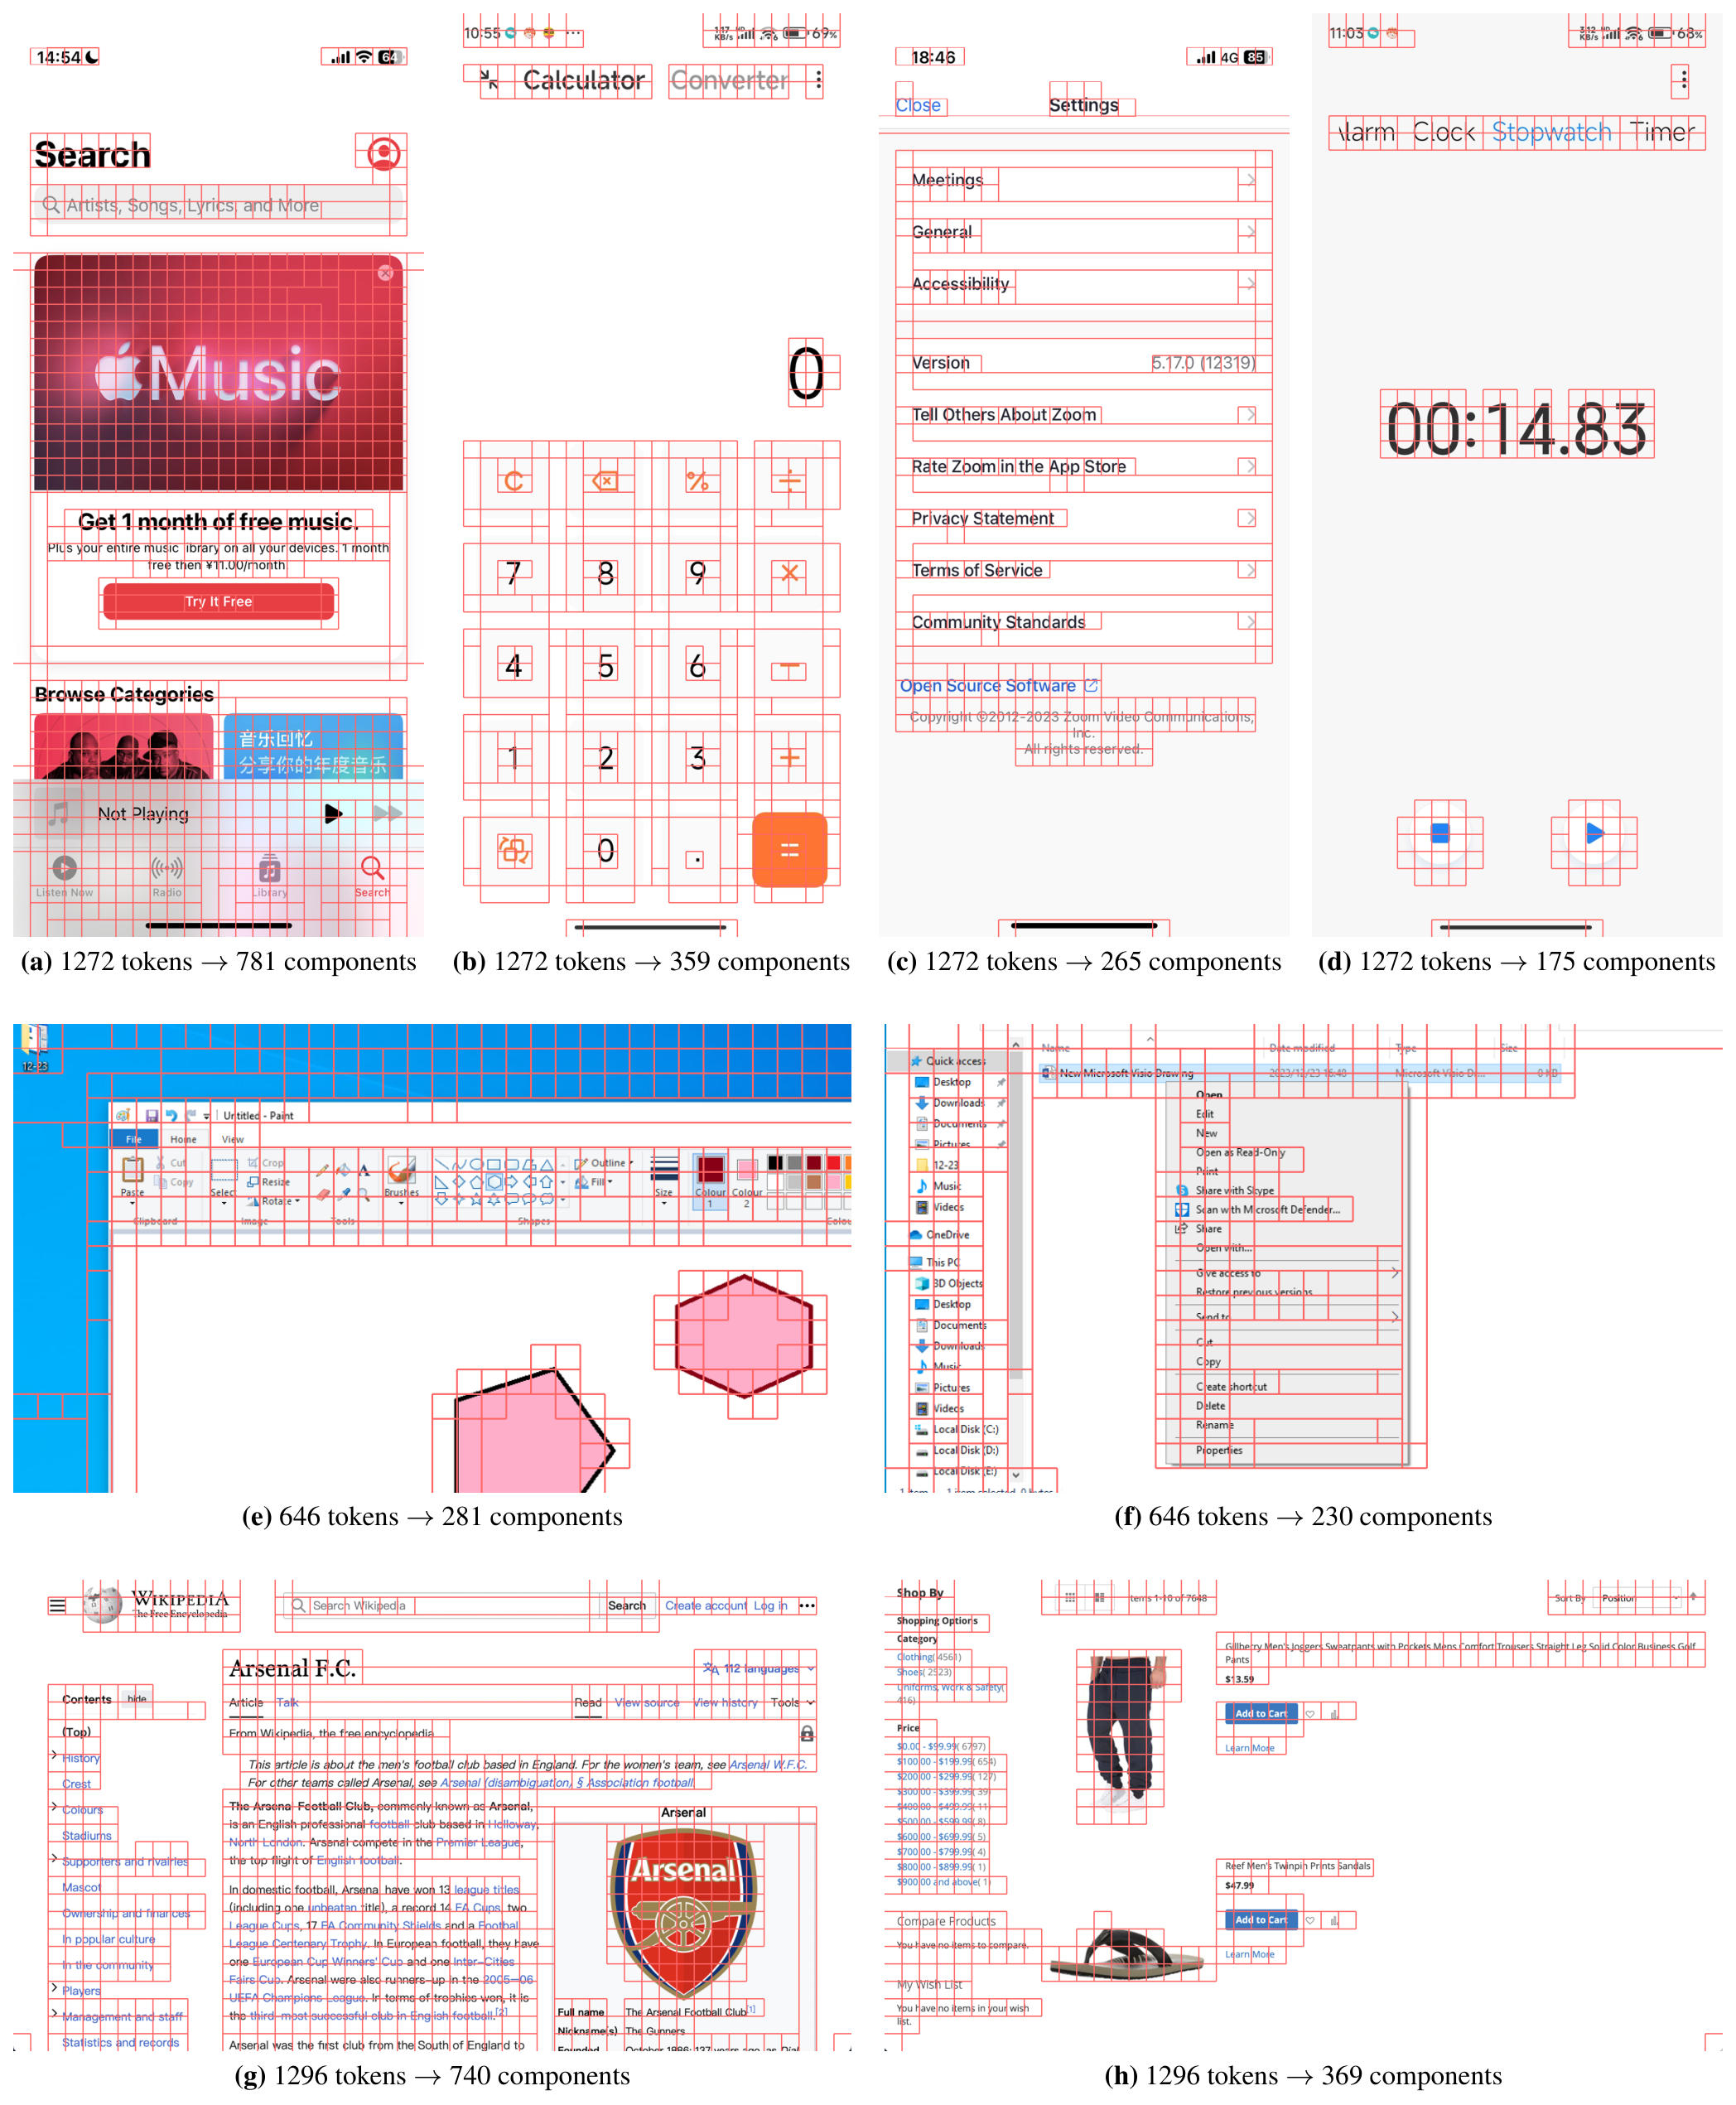 論文原圖編號:Figure 5。行動裝置、桌面與網頁畫面的連通圖範例;不同介面密度會自然產生不同元件數,說明壓縮率不是固定裁切。
交錯式視覺—語言—動作串流
Action-Visual Streaming 解決的是跨步驟狀態:序列保留前一步畫面與動作,再加入執行後的新畫面來預測下一個動作。論文實驗的歷史長度為 2,因此證據只支持短期上下文,不能外推到很長的工作流程。作者也可依應用程式切換遮蔽較舊畫面,以控制記憶體成本。
Action-Query Streaming 解決的是訓練效率:同一張截圖只編碼一次,後方交錯多個查詢及其目標動作。這相當於把共同的視覺前綴攤銷給多個元素級監督;它不會憑空增加新畫面,而是更充分利用同一畫面的標註。
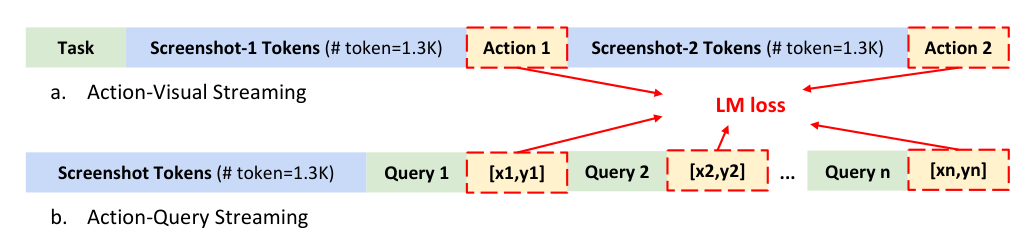 論文原圖編號:Figure 6。兩種交錯串流格式及語言模型損失的位置;圖中清楚區分跨畫面歷史與單畫面多查詢的不同目的。
關鍵訓練細節
指令微調使用 32 張 V100,下游調適使用 8 張 V100;每張卡批次為 1、梯度累積為 2,採 fp16、DeepSpeed ZeRO-2 與縮放點積注意力。LoRA 的秩為 64、縮放係數為 128,同時作用於語言模型與視覺編碼器,可訓練參數約占 4%。學習率為 1e-4,最大視覺區塊數為 1280,完整微調約需兩天。介面圖遮蔽比例的主要設定為 0.75,稀疏模組由第 14 層附近開始交錯插入;實際重現時,這些位置與取樣規則比方法名稱本身更容易影響結果。
關鍵結果
零樣本畫面定位
在 ScreenSpot 上,ShowUI 的平均定位分數為 75.1,高於 SeeClick 的 53.4、OmniParser 的 73.0 與 UGround 的 73.3。文字元素普遍比圖示容易:ShowUI 在行動裝置文字/圖示分別為 92.3/75.5,桌面為 76.3/61.1,網頁為 81.7/63.6。因此總平均的領先不能掩蓋圖示定位仍是較弱環節。
| 方法 | 輸入或設定 | ScreenSpot 平均分數 |
|---|---|---|
Qwen2-VL-2B | 基礎模型 | 9.3 |
CogAgent | GUI 專用代理 | 47.4 |
SeeClick | 純視覺定位 | 53.4 |
OmniParser | 解析式介面表示 | 73.0 |
UGround | GUI 定位模型 | 73.3 |
ShowUI-G | 僅定位配方 | 74.9 |
ShowUI | 定位與導航聯合訓練 | 75.1 |
[!figure] Table 2 ScreenSpot 零樣本定位結果 建議位置:關鍵結果 放置原因:這是論文最核心的跨裝置定位比較,承載
75.1平均分數與文字/圖示細分;正文另以精簡表格重建主要數字。 目前狀態:保留占位;未擷取到可獨立辨識且通過視覺檢查的完整原表。
導航結果與歷史效益
AITW 行動導航中,基礎 Qwen2-VL-2B 為 67.2;沒有交錯視覺歷史的 ShowUI† 為 68.3,完整模型為 70.0。也就是說,短期畫面—動作歷史帶來 1.7 分的額外提升,但零樣本版本只有 35.9,顯示導航成績高度依賴任務調適,不能由定位能力直接推得。
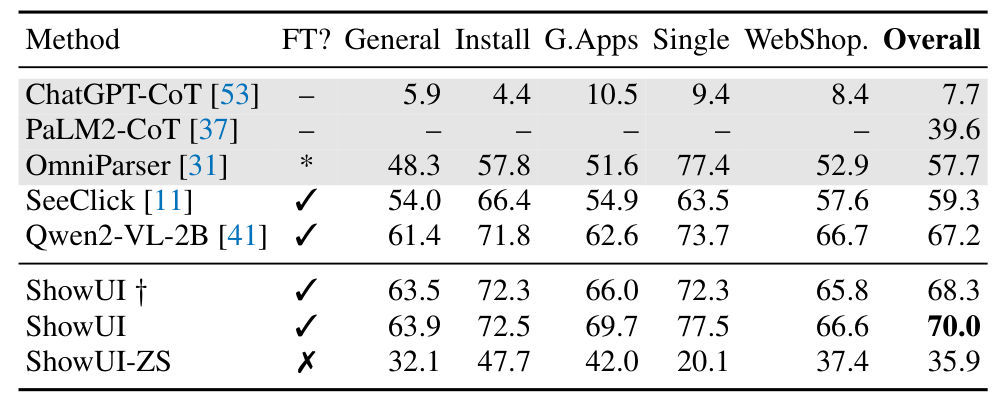 論文原圖編號:Table 3。
AITW 各類行動導航結果;完整歷史、無視覺歷史與零樣本設定的差距直接界定了方法的有效範圍。
在 Mind2Web,完整 ShowUI 的跨任務、跨網站與跨領域步驟成功率分別為 37.2/35.1/35.2,相較基礎模型的 33.2/27.6/30.7 有改善;但完整模型與 ShowUI† 的差距只約 0.3–1.1 分,表示這個基準受限於較少的動作類型與相似網站,視覺歷史的邊際效益不大。MiniWob 線上導航中,完整模型為 71.5、ShowUI† 為 70.4,而零樣本僅 27.1;這再次說明離線指令微調尚未解決線上錯誤分布與復原問題。
消融揭示的取捨
權杖選擇比例為 0.5 時,平均視覺上下文由 1344 降至約 947.4,ScreenSpot 分數僅由 70.8 降至 70.4;比例提高到 0.75 與 1.0 時,分數則降至 68.3 與 64.5。換句話說,冗餘確實存在,但不是所有同色元件都可安全刪除。介面圖引導的選擇在相近計算量下優於隨機選擇;直接權杖合併更快,卻明顯損害定位,符合「精確座標需要保留局部權杖身分」的機制解釋。
資料消融也支持品質與平衡的重要性。網頁原始資料配方得到 65.5,加入文字與視覺篩選後為 66.6,只保留更依賴視覺的元素達 69.0;桌面資料加入多樣查詢後由 68.7 升至 70.9。各來源直接聯合訓練的平均分數為 71.2,平衡取樣後升至 74.9。
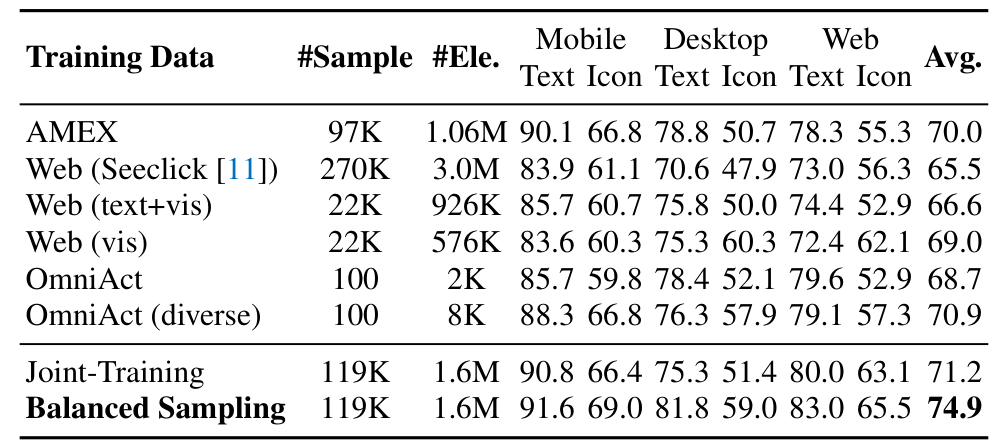 論文原圖編號:Table 6。不同資料來源、視覺篩選、查詢擴增與平衡取樣的消融;它支持資料配方而非純資料量是主要增益來源之一。
深度分析
真正貢獻是系統配方,而非單一新模組
ShowUI 的強項是三個選擇互相補足。介面圖稀疏化降低每張畫面的權杖成本,讓串入歷史畫面較可行;交錯串流把定位與導航整理成相容的序列格式;資料篩選與平衡則避免模型把容量浪費在只需文字辨識的簡單樣本。任何單一模組都不算難以替代,但組合後形成一條清楚、可重現且適合小模型的路線。
這也解釋結果分布:ScreenSpot 的強零樣本定位主要證明模型學到跨裝置的畫面—座標對齊;AITW 中完整歷史相對無歷史版本的提升,才較直接支持狀態串流;資料消融則支持篩選與取樣策略。三組證據分別對應三項機制,不能只以最高的 75.1 一個數字替全部方法背書。
為什麼介面圖選擇可能成立
該論文有一個主要預設: 大片背景、面板與規則排列常具低頻、重複結構,而真正決定動作的文字、圖示、邊界與控制元件較稀疏。So it might not working well on complex gui. 例如遊戲介面等(或許之後會讀UITARS)
用相鄰色差建立元件,是一種極低成本的結構先驗。在論文示例中,較稀疏的 Google 畫面可由 1296 個權杖形成約 291 個元件,密集的 Overleaf 畫面則形成約 986 個元件;因此同一規則會依介面資訊密度自動調整壓縮空間。
但這個先驗只近似「相似顏色代表冗餘」,並不等同語義重要性。漸層、動畫、壓縮雜訊、深色模式、細線條圖示與高對比無障礙主題,都可能使色差閾值失準。論文證明它在既有基準上有效,尚未證明這是跨渲染引擎與動態介面的穩健分割方法。
現在的論文寫法be like: 嘿我夢到一招不錯的,那我想辦法說個故事測出來他很強
與強baseline相比,改變的是哪個瓶頸
相較仰賴 HTML 或無障礙樹的代理,ShowUI 的價值是可在只有像素的介面上運作;代價是必須從視覺中重新推斷元素結構。相較 SeeClick 等純視覺定位模型,它不只增加資料,還用權杖選擇與串流格式把定位延伸到多步導航。相較更大的通用視覺語言模型,它展示 2B 模型在專用資料與訓練協定下可以相當有競爭力,但論文沒有在完全相同資料、解析度與調適預算下,系統比較各種模型規模,因此不能把結果解讀為小模型普遍優於大模型。
哪些地方容易被誤讀
第一,75.1 是靜態零樣本定位分數,不是端到端任務成功率。第二,摘要中的 33% 權杖減量與 1.4× 加速屬特定設定,稀疏比例再提高會明顯掉分。第三,「單一模型」指共同參數與序列介面,不代表所有基準都採零樣本;導航主結果仍含下游調適。第四,部分基線使用的輸入、外部結構或微調條件不同,排行榜差距不完全等於架構差距。
可重用的工程洞見
若要在新的 GUI 模型重現這條路線,應優先保留四個實驗軸:介面結構引導與隨機選擇的等計算量對照、選擇與合併的座標精度對照、含/不含畫面歷史的導航對照,以及未平衡/平衡資料取樣的對照。這四組實驗比單純重跑總分更能判斷增益究竟來自計算策略、狀態表示或資料分布。
限制
- 離線監督與線上互動仍有落差。
MiniWob的零樣本27.1遠低於調適後的71.5,而論文沒有納入線上強化學習、主動探索或錯誤復原;真實介面中的延遲、彈窗與狀態漂移可能放大差距。 - 歷史證據只涵蓋短上下文。 主要設定的歷史長度為
2。它支持「最近畫面與動作有幫助」,但沒有回答長達數十步的記憶、摘要、上下文成本與錯誤累積。 - 介面圖仰賴簡化的視覺假設。
RGB色差和四鄰接容易實作,卻未針對動畫、透明圖層、縮放、視訊壓縮或無障礙顯示做系統壓力測試;固定閾值也可能跨裝置失配。 - 資料增強可能帶入教師偏差。 桌面查詢由
GPT-4o擴增,論文展示其效益,但沒有細分錯誤率、語言風格偏差或與測試指令的相似性。網頁元素篩選也可能移除在真實工作流程中仍有用的文字目標。 - 比較協定不完全同質。 不同方法可能使用不同結構化輸入、資料量與調適方式;因此適合判斷整體系統位置,不適合作為單一模組的嚴格因果比較。
- 失敗案例顯示語義歧義尚未解決。 放大/縮小、同頁多個登入入口、相似連結與多個軟體視窗,都可能讓模型選錯可操作元素。這些錯誤不是增加定位資料就必然能消除,還涉及意圖澄清與狀態推理。
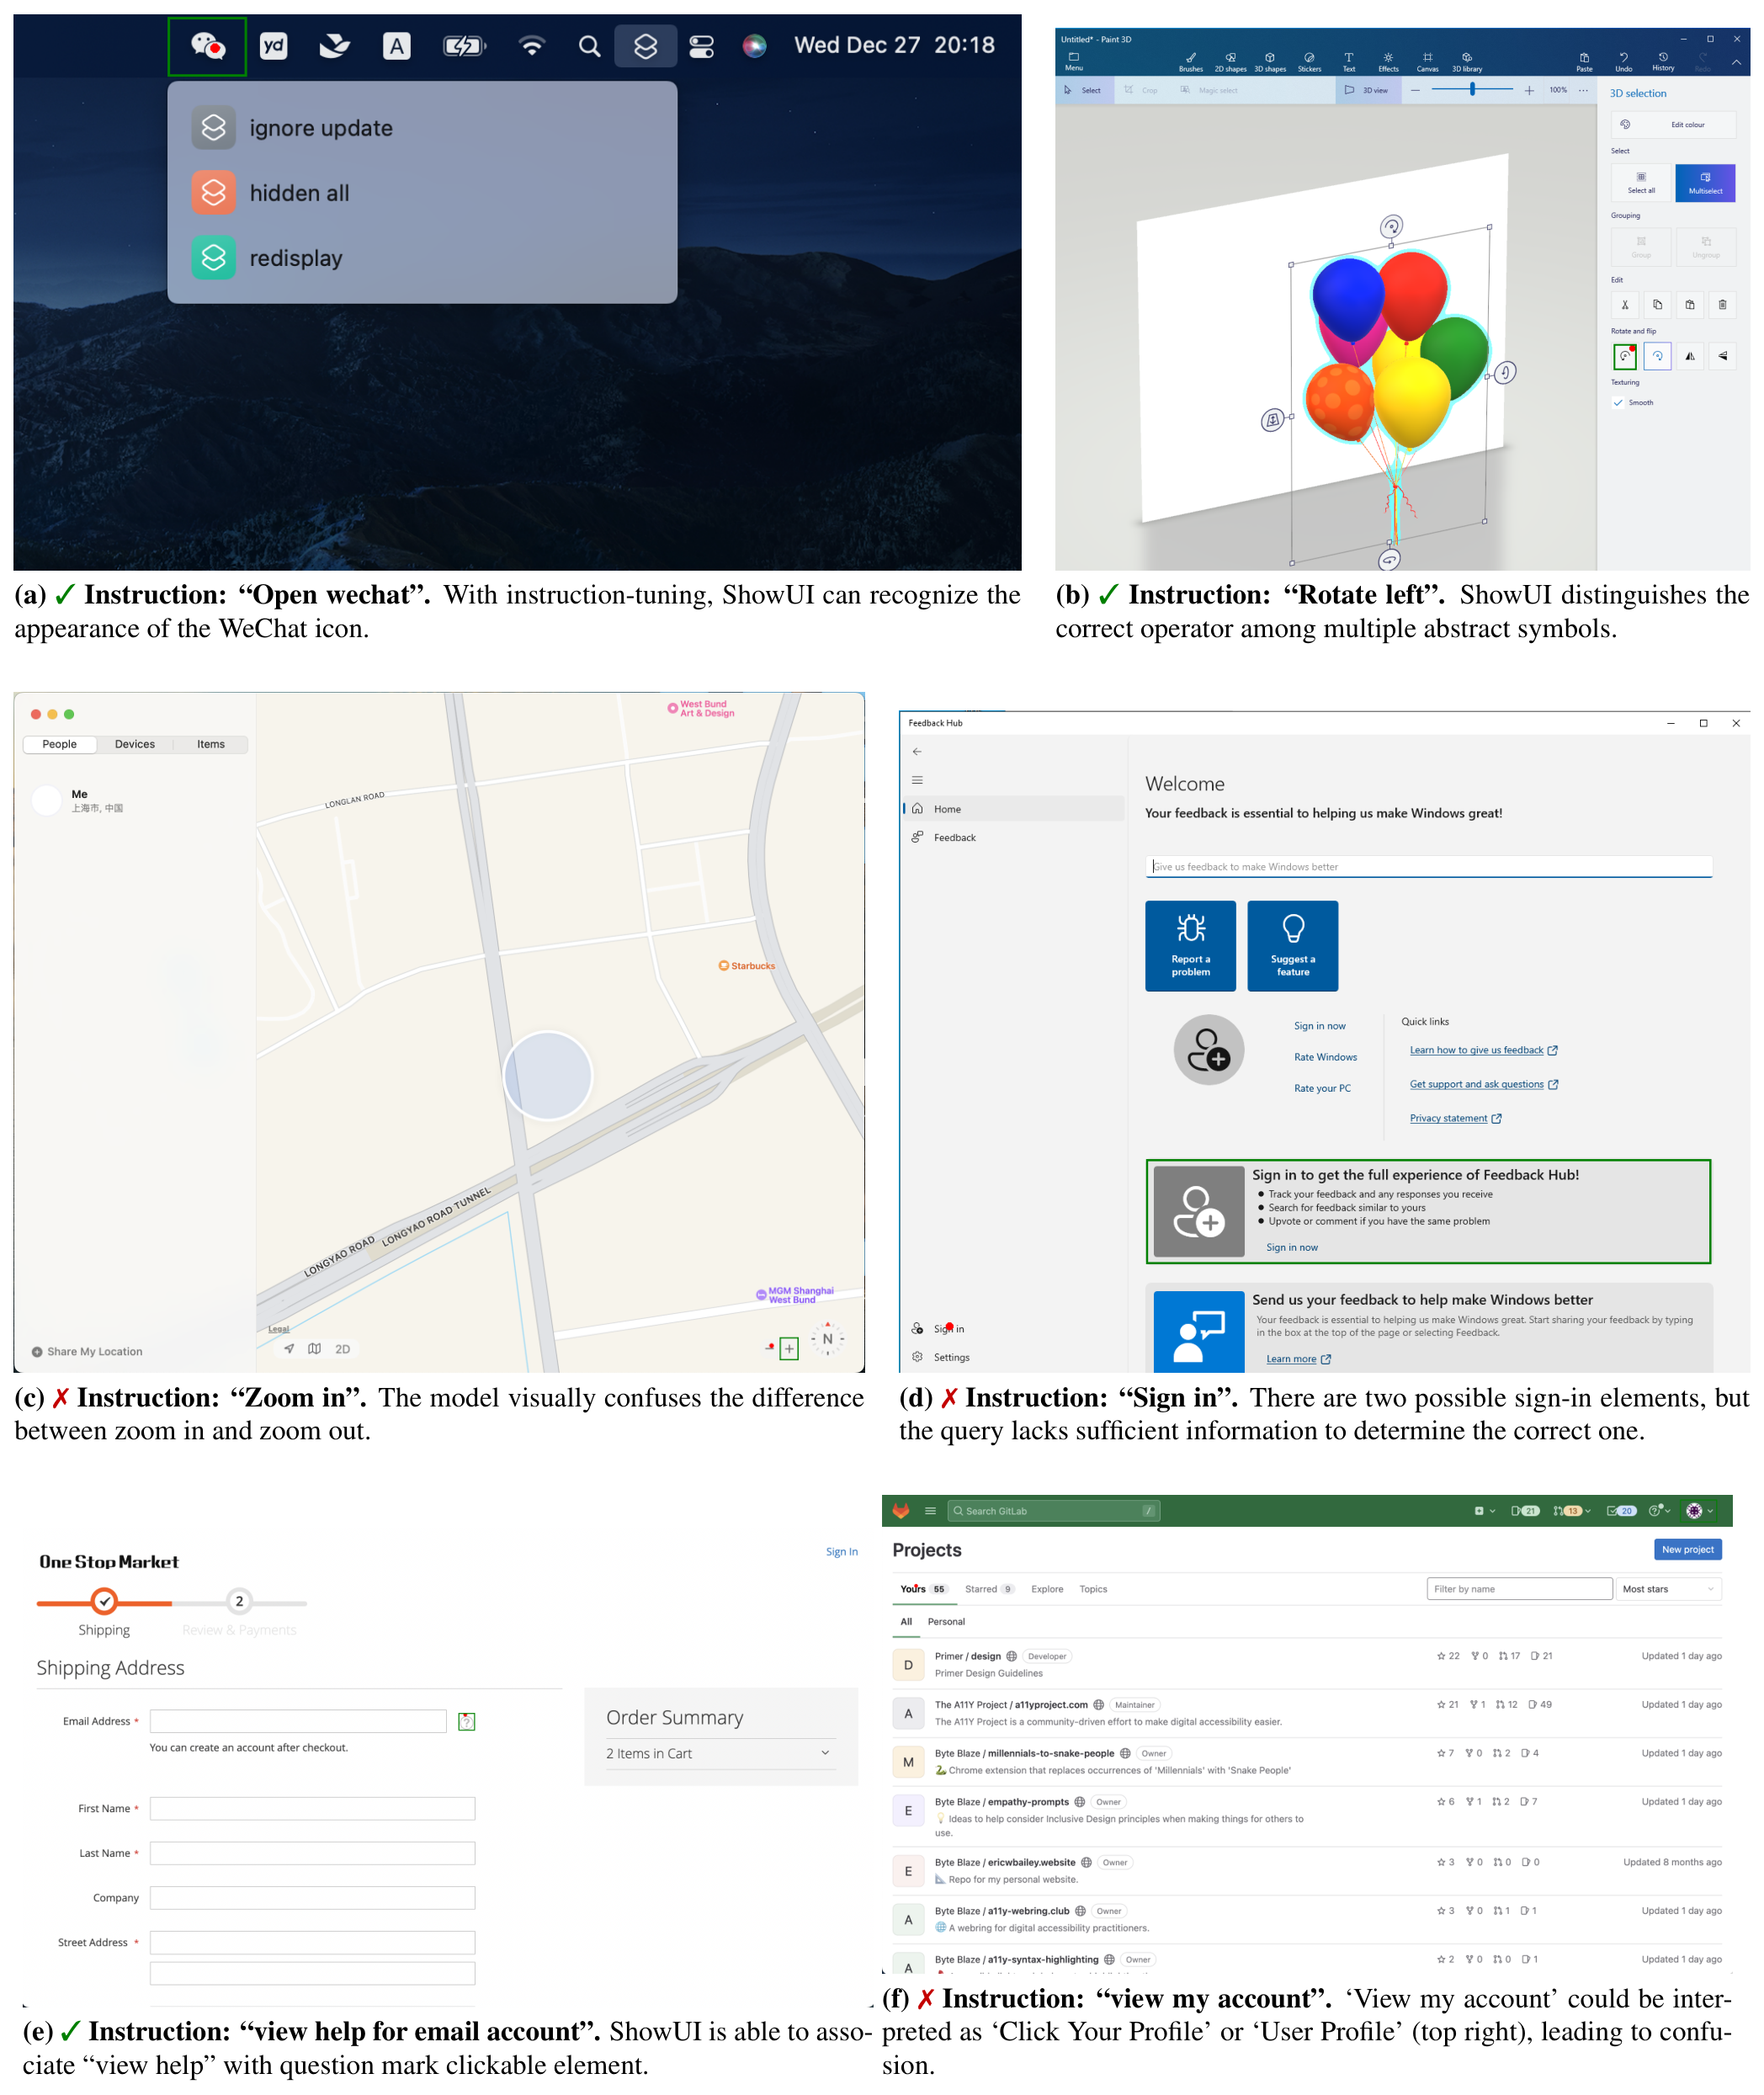 論文原圖編號:Figure 12。桌面與網頁定位的成功及失敗案例;多候選元素與模糊指令顯示高平均分數下仍存在語義歧義。
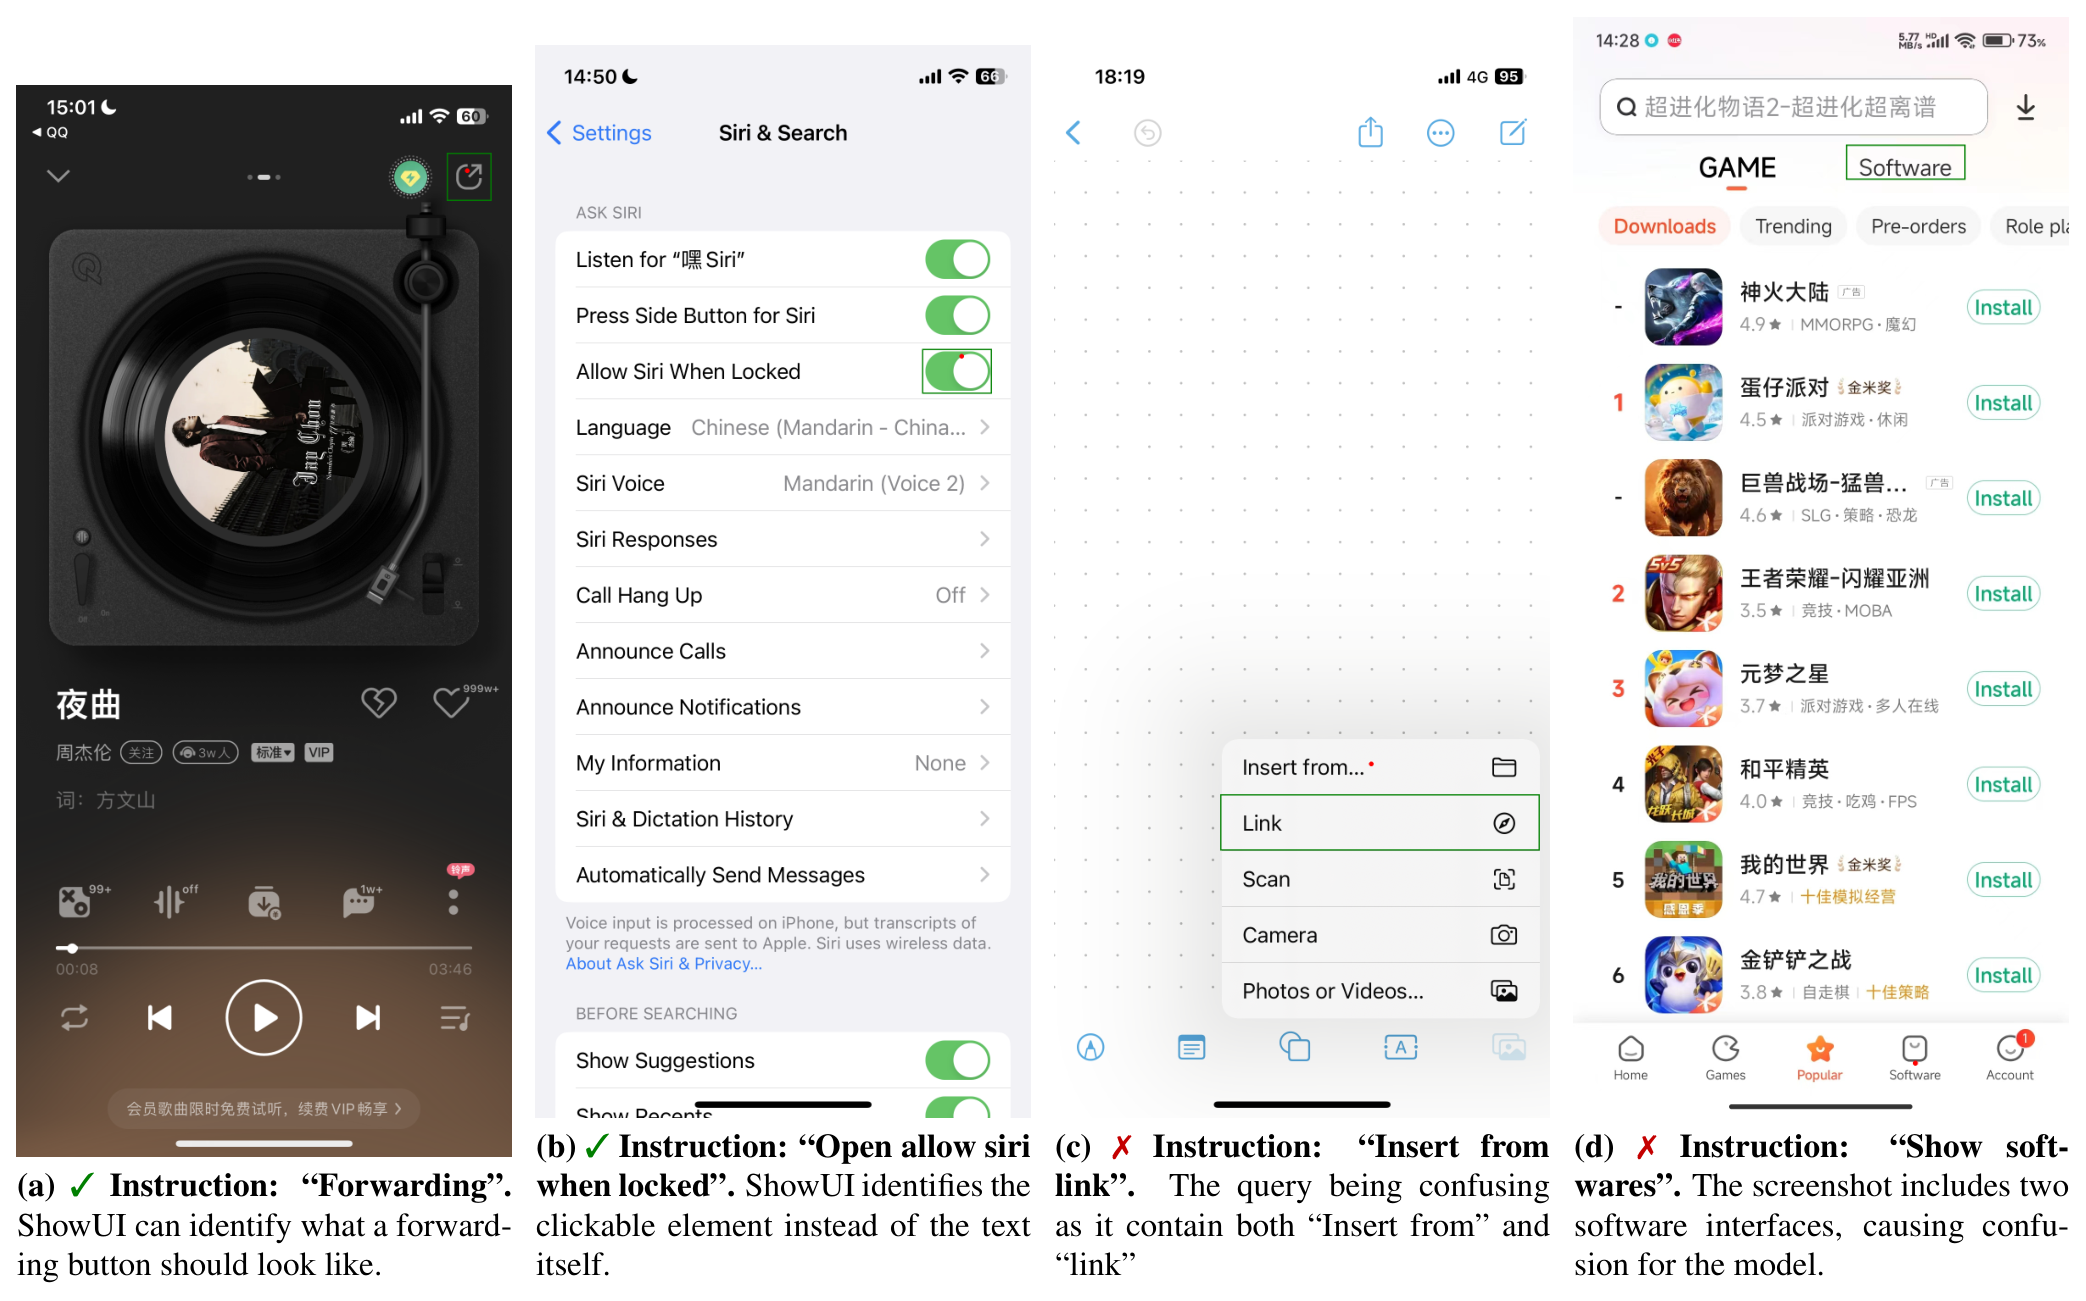 論文原圖編號:Figure 13。行動裝置案例呈現文字、圖示與可點擊區域的混淆;它補足量化表格無法描述的錯誤型態。
Notes
附錄隨筆
當初我做碩論前有想到這方面的Agent操作(只抓出介面實際有用的區塊 通常是非留白處),但實際上沒想到可以透過這個方式降低所需要的vision token數量,後來也沒做那方向
引用
- Cheng et al. (2024). SeeClick: Harnessing GUI Grounding for Advanced Visual GUI Agents.
- Hong et al. (2024). CogAgent: A Visual Language Model for GUI Agents.
- Zhang et al. (2024). UGround: Universal Visual Grounding for GUI Agents.
- Rawles et al. (2023). Android in the Wild: A Large-Scale Dataset for Android Device Control.
- Deng et al. (2023). Mind2Web: Towards a Generalist Agent for the Web.
- Shi et al. (2017). World of Bits: An Open-Domain Platform for Web-Based Agents.